自定义模板OCR识别场景
简介
场景简介
自定义版式OCR识别技术,通过OCR解析图像或扫描件中的文本信息,并结合用户自定义的版式模板精准提取所需数据字段。该技术可显著提升文档处理效率与数据准确性,有效削减人工录入环节的成本支出及误差风险。
应用场景
OCR技术可以用于多种场景下的数据提取与处理,如:
- 文档处理:解析含有财务数据、审计记录等结构化信息的单据或表格;
- 文件上传:从图片或PDF中自动提取相关信息并完成资料录入;
- 数据录入:识别并输入实验仪器记录、采购订单等非结构化文本;
这些场景都需要高效准确地识别数字、字母和特定符号,以支持自动化工作流程的优化。
预期效果
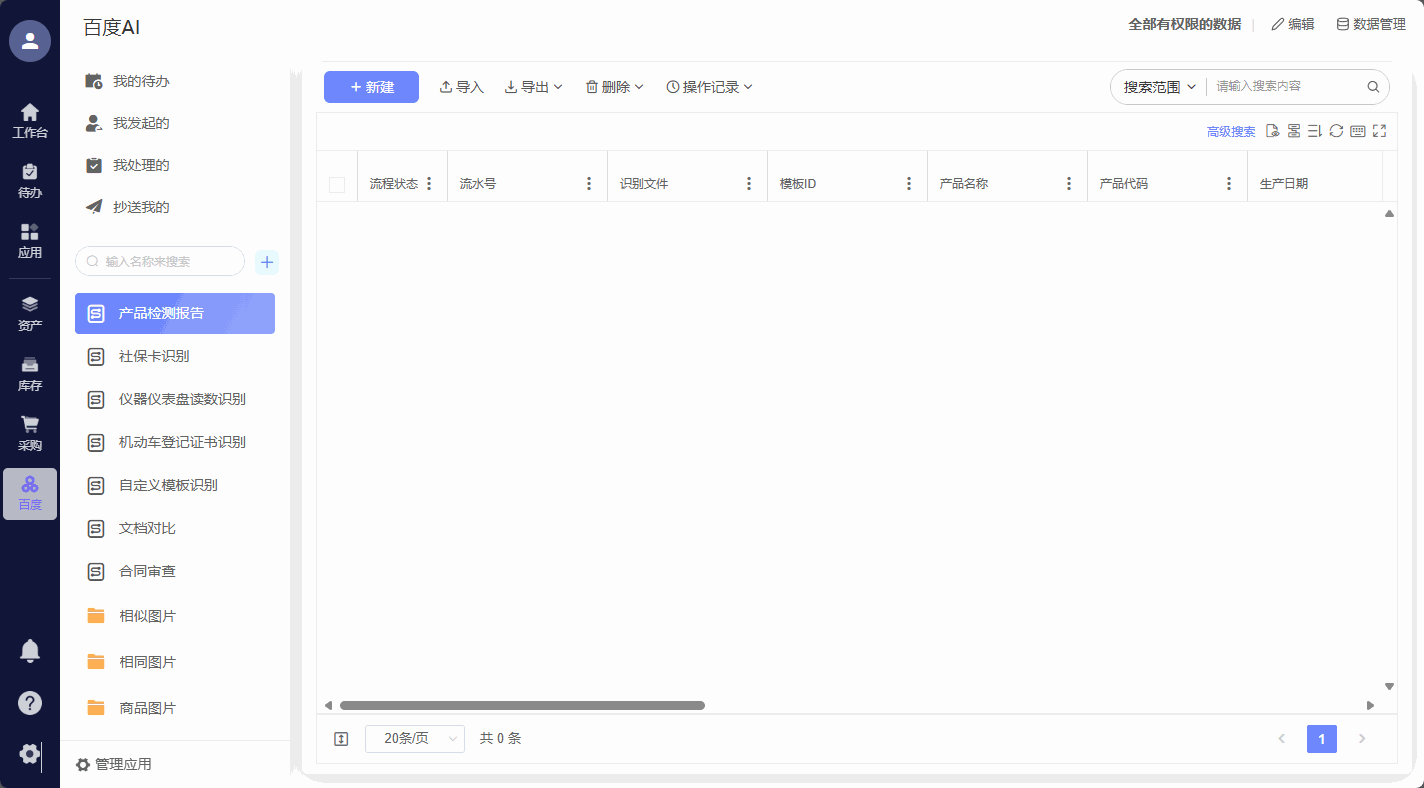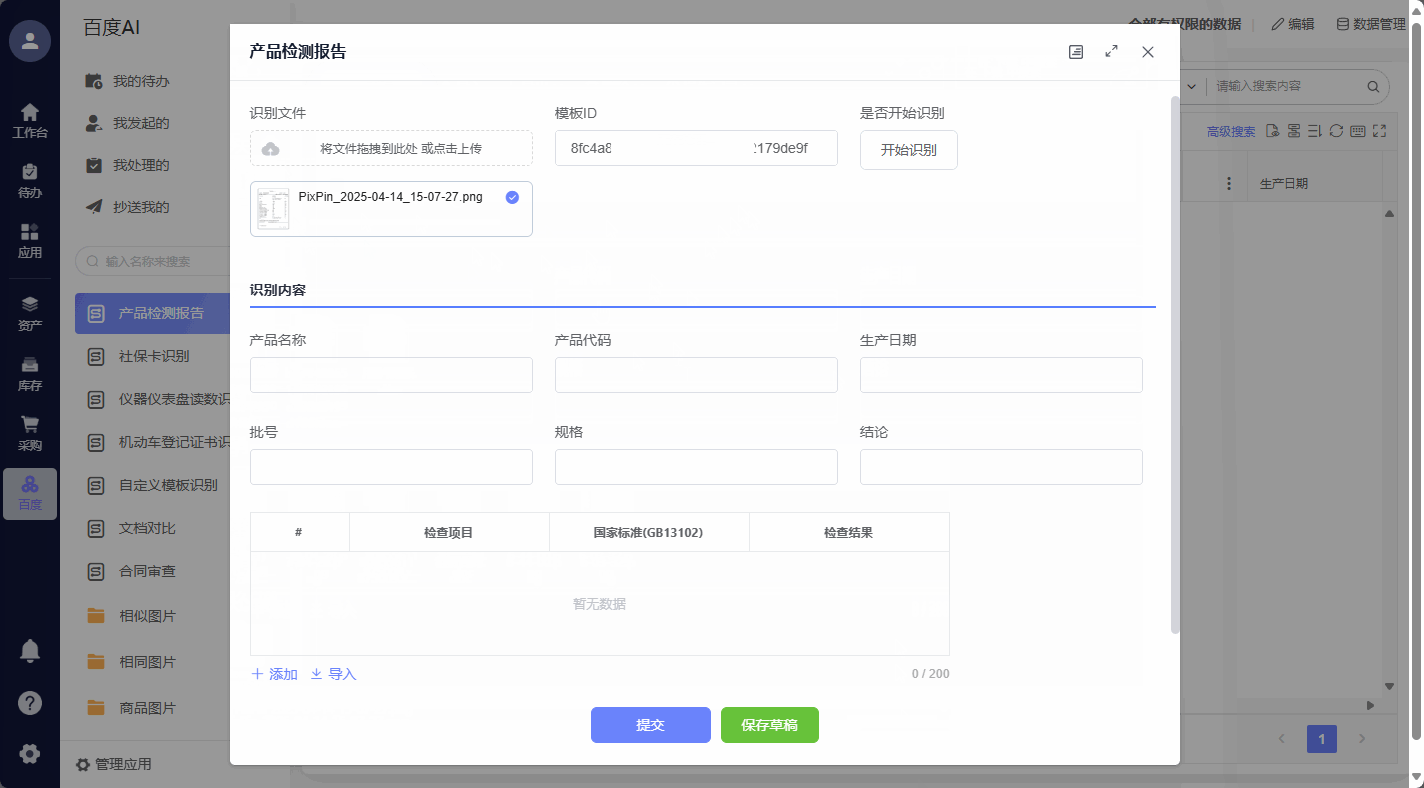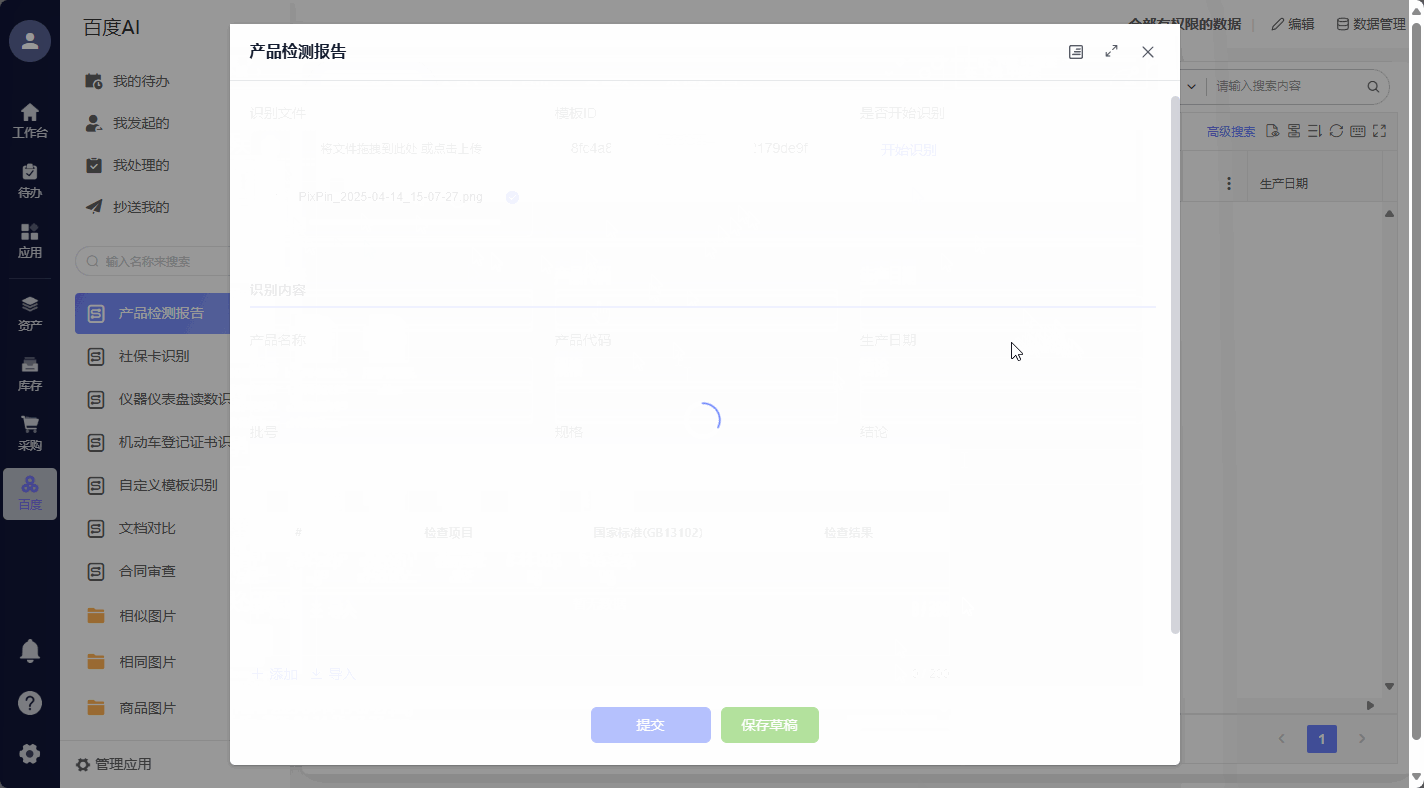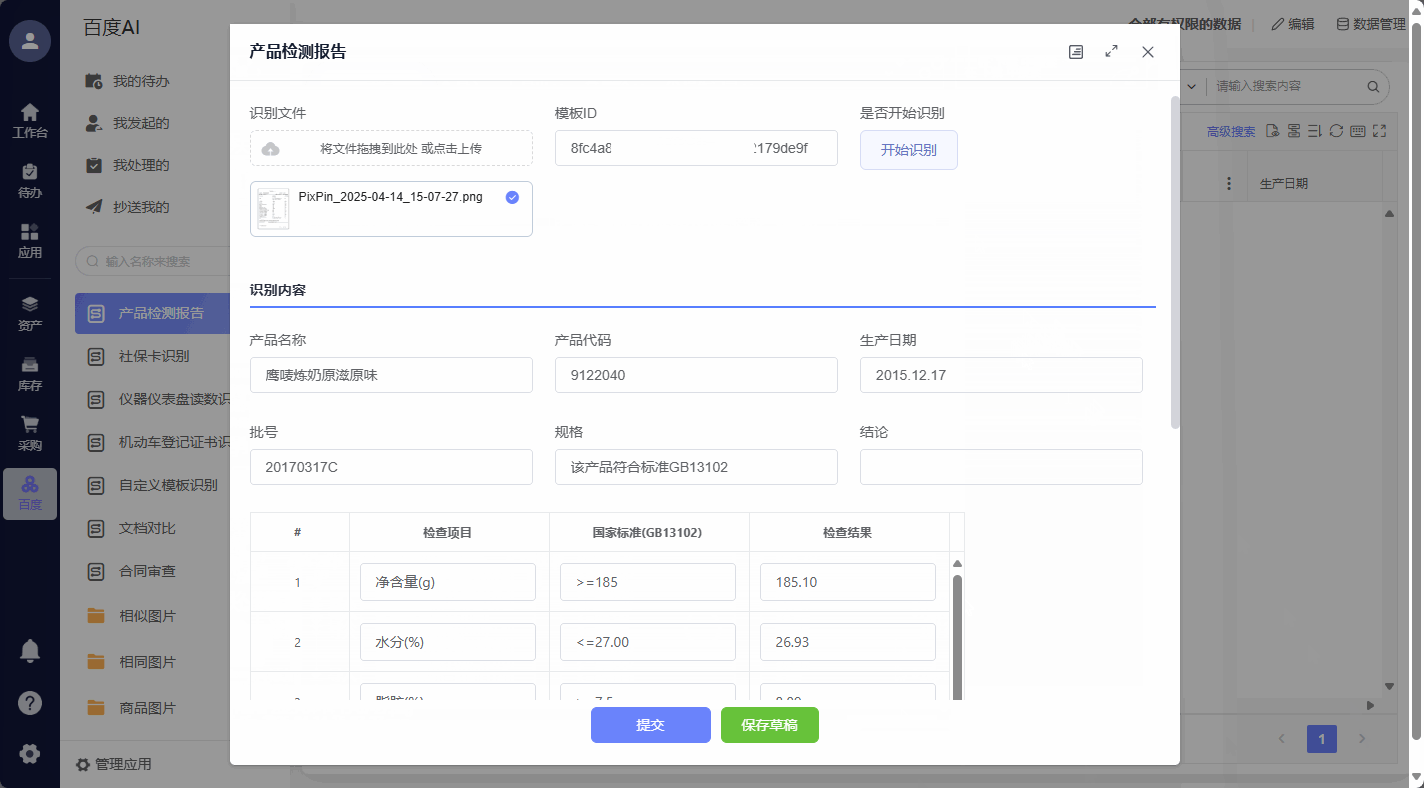
以 OCR 识别产品检测报告为例,效果如下所示:
自定义模板配置
模板详细配置可参考百度大脑AI开放平台上的iOCR 自定义模板文字识别。
创建模板
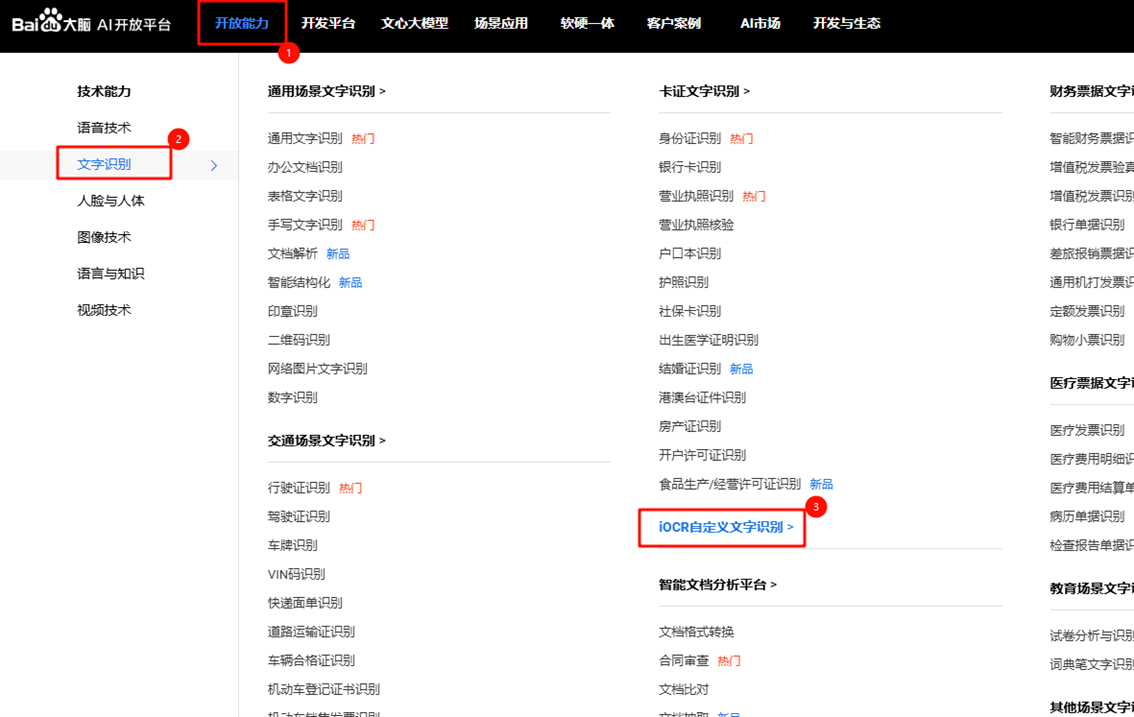
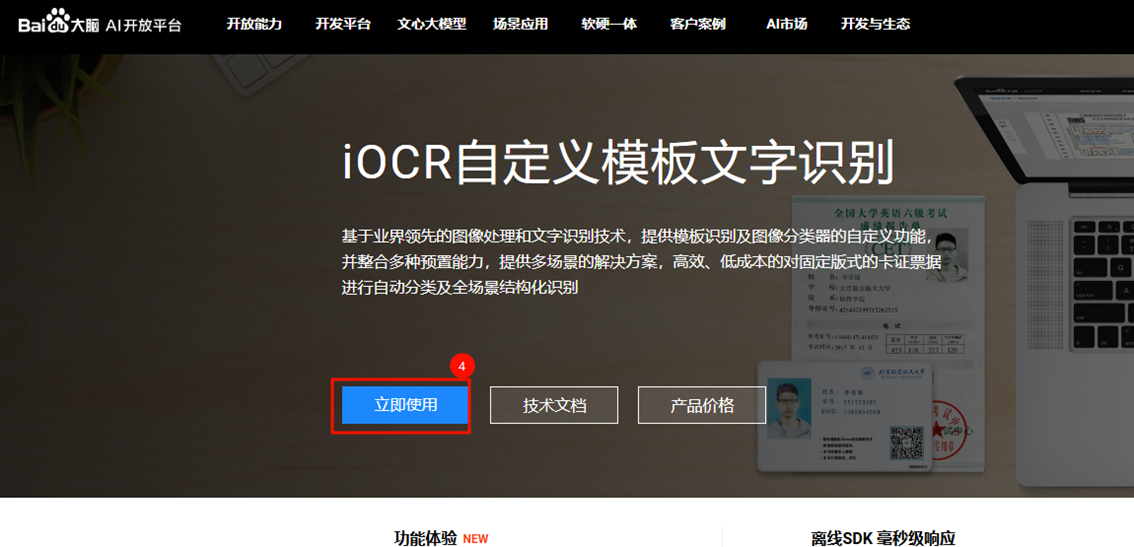
1)在「开放能力 >> 文字识别」位置,点击「 iOCR 自定义模板文字识别」。进入文字识别详情页后,点击「立即使用」,如下图所示:
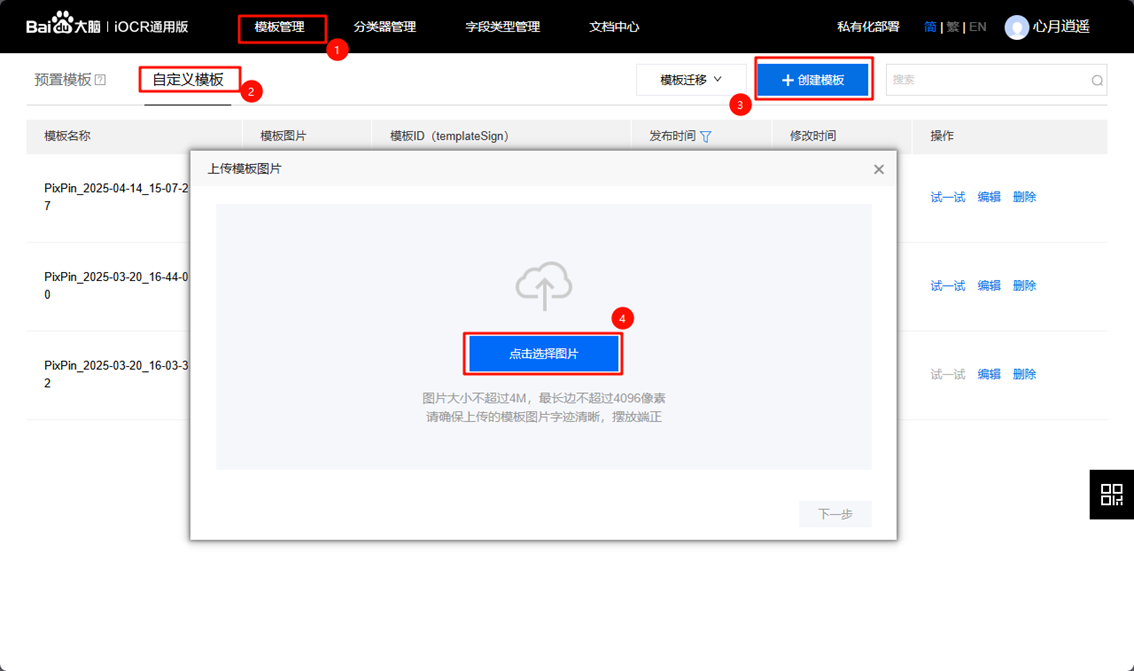
2)在「模板管理 >> 自定义模板」位置,点击「创建模板」并上传模板图片,如下图所示:
编辑模板
1)框选参照字段
成功上传模板图片后,进入模板编辑界面,点击“第1步:框选参照字段”按钮,在模板图片中勾选需要作为参照的关键字段,例如产品名称、产品代码、签发及签发日期等字段,具体操作步骤如下:
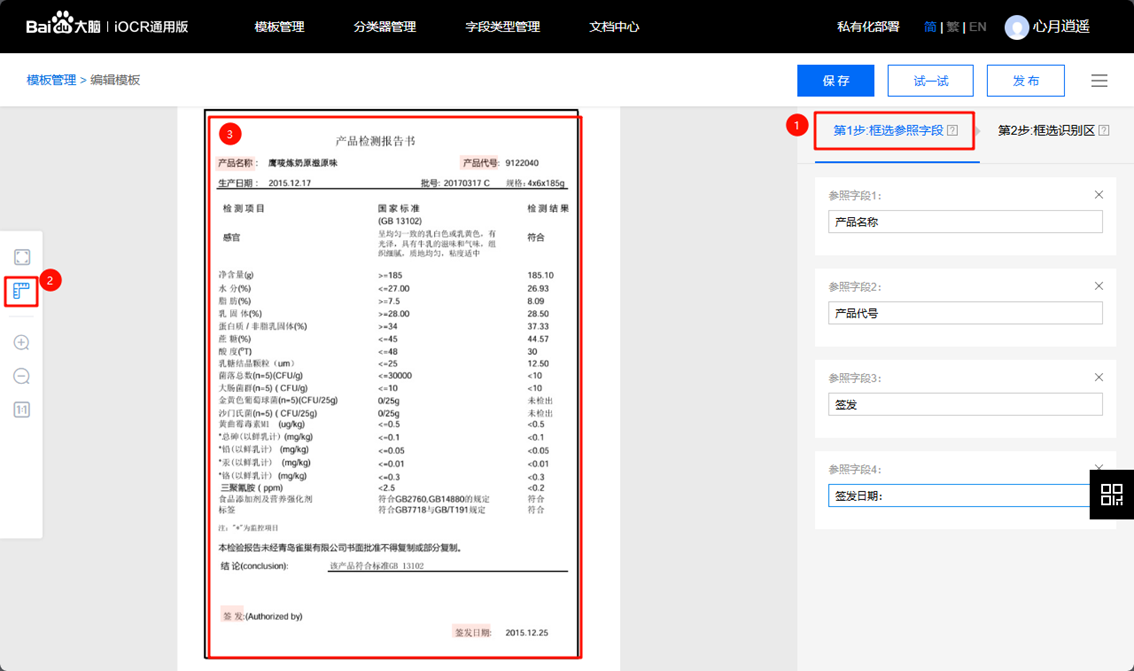
2)框选识别区
接下来点击“第2步:框选识别区”,在模板图片中选取需要提取信息的区域,并在右侧面板调整对应的字段名称,确保识别结果准确对应所需数据项。
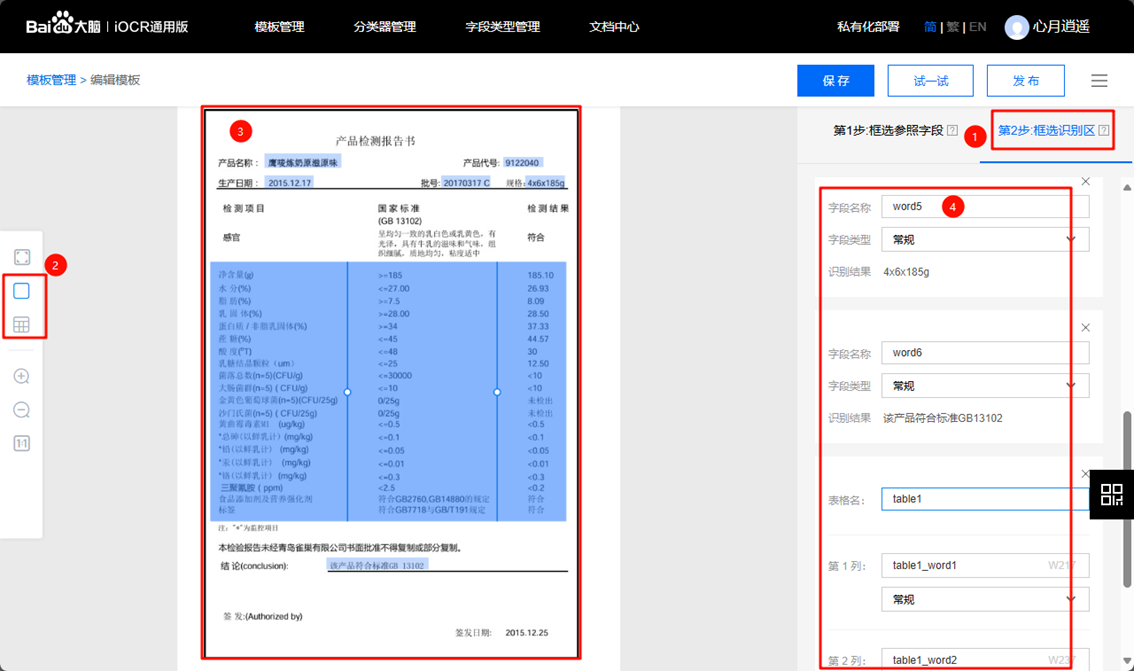
注:字段名使用如下规则命名,便于百度大脑(AI)插件前端事件配置中返回结果的定位。
字段名称:【word+数字】的形式,例:word1、word2;
表格名:【table+数字】的形式,例:table1、table2;